はじめに
こんにちは。3D エンジニアの中川です。暑い夏も過ぎ去り、最近は少し過ごしやすくなってきました。皆様いかがお過ごしでしょうか。
前回は AIMERA にハンドルをつけて Visual SLAM を動かしてみる、というお話でした。動画を撮影しながら、3D 空間中の点群とカメラ姿勢(位置と向き)が同時に得られるというものですね。
ここで皆さん、最近は画像だけ入れたら点群とカメラ姿勢がポンと出てくる AI(基盤モデル)が存在することはご存じでしょうか? 「feed-forward 3D reconstruction model」を基に「feed-forward な手法」なんて呼ばれたりしますが、本ブログでは「ポンと出す AI」としましょう。現在この分野は非常に熱く、2023 年末に発表された DUSt3R という手法を皮切りに、様々な手法が提案され、今も数ヶ月おきに新しい手法が発表されているような状況です。
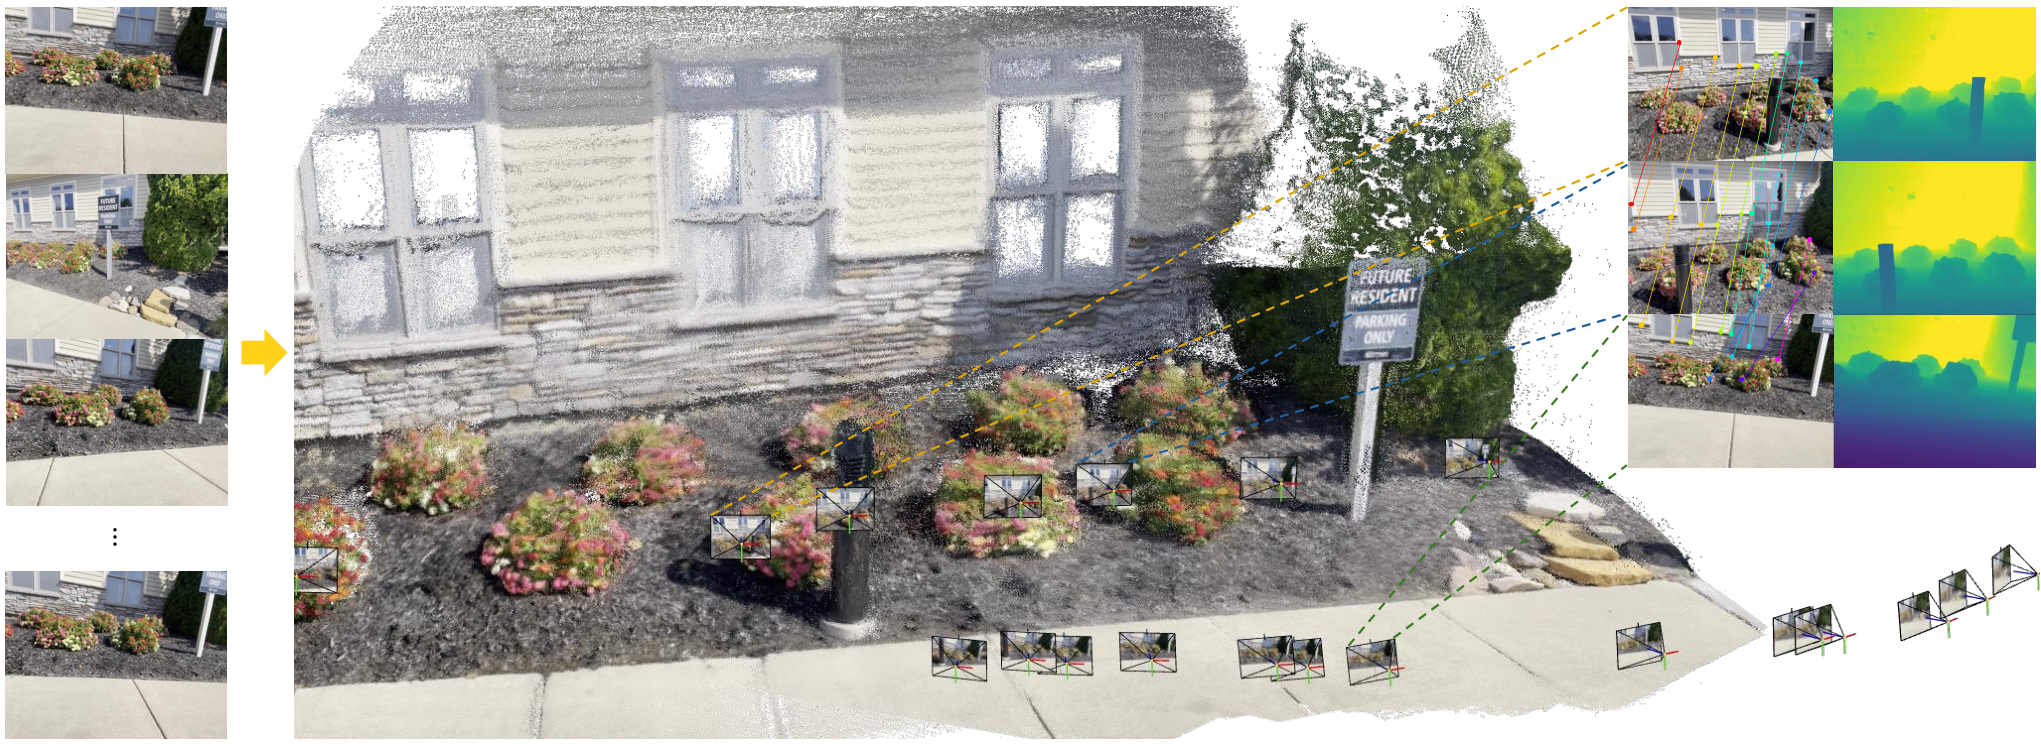
もう SLAM や SfM はいらなくない?という気もしてきてしまうのですが、そこはまだまだ発展途上。画像枚数に合わせて GPU メモリもたくさん必要ですし、入力画像の中に似たような画像が複数あれば失敗してしまう場合もあります。条件にもよりますが、長年研究が積み重ねられてきた SLAM や SfM の方がまだ少し分がある印象です。
そんな中、最近面白い手法が発表されていました。それがタイトルにも書いた ScaRF-SLAM という手法です。ScaRF-SLAM は以前からある SLAM と、最先端の AI を組み合わせて上記の弱点を克服しつつ、いいとこ取りを実現しています。
今回はその ScaRF-SLAM を動かしてみたというお話です。
ScaRF-SLAM とは
大雑把に書くと、ScaRF-SLAM は以下の三段階の処理で構成されています。
- Visual-Inertial SLAM でカメラの軌跡と疎な点群を求める
- 基盤モデル Depth Anything 3 を使って画像の画素毎の奥行き(デプス画像)を求める
- 1 の軌跡から 2 のデプス画像を 3D 点に起こし、複数の視点で同じ場所が重なるようスケールを調整して密な点群を作る
Visual-Inertial SLAM (VI-SLAM) について
いままで Visual SLAM と言っていたのに突然 Inertial というのがやってきました。この Inertial は Inertial Measurement Unit (IMU) から来たものです。IMU は加速度センサと角速度(ジャイロ)センサが組み合わさったもので、皆様がお持ちのスマートフォンなどにも入っているのではないかと思います。
カメラ (Visual) と IMU (Inertial) を使った SLAM で Visual-Inertial SLAM (VI-SLAM) ということですね。詳しい説明は省きますが、近年の SLAM はこの IMU を上手く組み合わせることによって性能面で大きな飛躍を遂げています。特に周囲に繰り返しパターンがあったり、壁にテクスチャ(模様)がなかったりすると、Visual SLAM は自己位置を見失ったり地図が破綻したりと失敗しがちだったのですが、IMU を組み合わせた VI-SLAM では大きく改善されました。
Depth Anything 3 (DA3) について
画像から画素毎の奥行き(デプス画像)を求める AI があるのですが、ScaRF-SLAM では Depth Anything 3 (DA3) というものが使われています。Depth Anything はもともと 1 枚の写真からデプス画像が得られるモデルだったのですが、昨年公開された Depth Anything 3 では、「ポンと出す AI」の流れが取り入れられ、複数の画像から整合性のあるデプス画像とカメラ姿勢を求めるモデルに進化しています。
また、カメラ姿勢は推定するだけでなく、入力として与えることも可能で、SLAM などで既にカメラ姿勢がわかっているならそれをヒントにデプスを推定することができます。ScaRF-SLAM でもこの機能を使っており、VI-SLAM で得られた姿勢を数フレームずつ DA3 に入力してデプスを推定することで、
- VI-SLAM で推定された高精度なカメラ姿勢情報を利用
- 画像枚数が多くなると GPU メモリの使用量も非常に多くなる問題を解決
しています。DA3 はカメラ姿勢も返してくれますが、これは使わず VI-SLAM の方を信じています。
ちなみに DA3 はモデルの種類によってライセンスが異なり、一部は商用利用が不可とされています。ScaRF-SLAM の公開されているソースコードでは最も大きなモデルを利用するようになっているのですが、本ブログでは BASE サイズのモデルに変更しています。
実験準備
それでは実験に向けて準備をしていきます。
まず ScaRF-SLAM の論文では Insta360 ONE RS という 360 度カメラが利用されておりました。同じカメラはありませんが、弊社にも Insta360 X5 という 360 度カメラがありましたのでこれを使うことにしました。
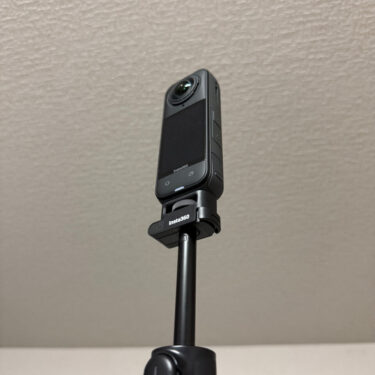
Insta360 は 2 つの魚眼カメラで全方位を撮影可能ですが、ScaRF-SLAM では前方の魚眼カメラだけを利用します。また、魚眼は端まで使わず、画角 160 度(中心から 80 度)の範囲だけを SLAM に使っています。さらに DA3 へ渡すのは、そこから切り出して歪みを取った画角 81.5 度 × 65.9 度の画像になります。
次に VI-SLAM のために IMU が必要になるのですが、なんと Insta360 には IMU が搭載されています。Insta360 を始めとするアクションカメラは、手ブレなどの補正に IMU を利用しているらしいです。Insta360 では IMU の計測値も動画と一緒に記録されますので、ありがたくこれを使わせてもらいましょう!
あとは細かい話として…
- 記録したデータから telemetry-parser というライブラリを利用して IMU 値を抽出
- カメラや IMU の各種キャリブレーションを Kalibr というツールで実施
- ScaRF-SLAM がデプス推定に利用している Depth Anything 3 のモデルサイズを BASE に変更
- ScaRF-SLAM が特徴点の抽出に利用している SuperPoint を ALIKED に変更
しました!
なお、今回も撮影しながらの処理は行わず、一度記録したファイルから必要なデータを取り出し、それを基に実行することにしています。以下に載せる動画も一度実行した結果から、密な点群が作られていく様子を再現したものです。
実験結果
はい、ということで動画がこちら! 実際の撮影時間に対して 4 倍速にしています。また、天井があると何もわからなくなるので、一定より高い位置の点群は非表示になるようにしました。
動画左側の画面が実際に撮影された映像で、右側の画面が点群やカメラの軌跡を描いたものです。壁の点群が非常に密なので平面に見えてしまいますね。こういう特徴の少ない床や壁、特に廊下で振り返るところなんて従来の Visual SLAM では苦しい場面だと思うのですが、魚眼カメラと VI-SLAM のおかげで大きく崩れることなく位置推定ができています。
出来上がった点群を描画した画像も貼っておきます。こちらも天井を削除し、さらに 1 cm3 につき 1 点になるように、点群を間引いて表示しています。
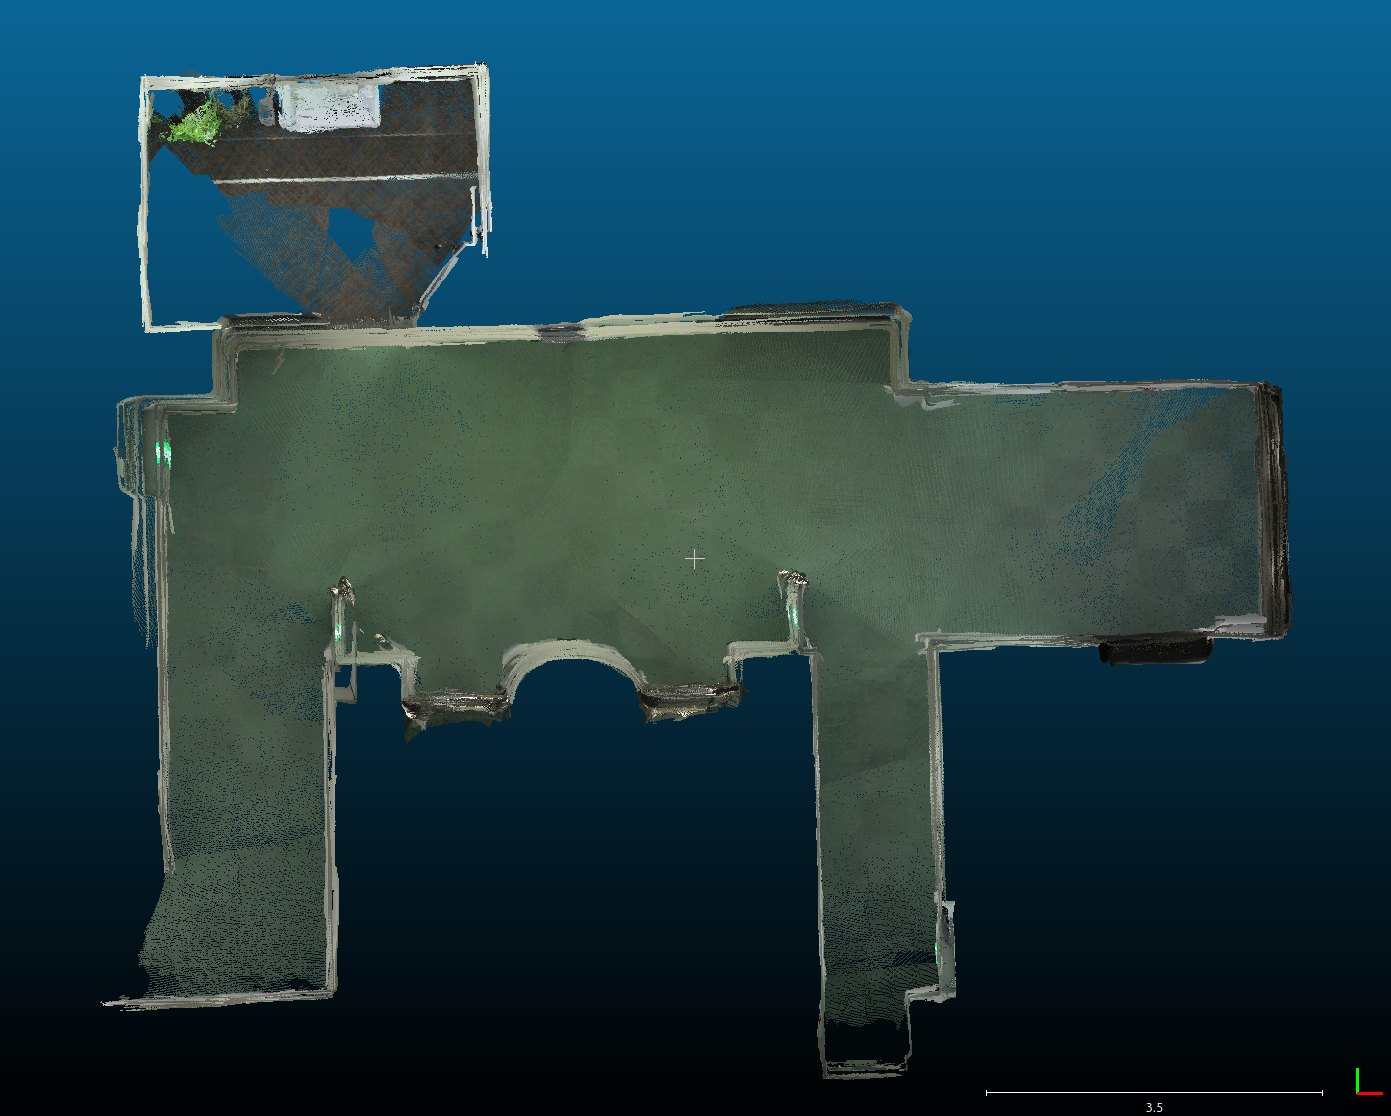
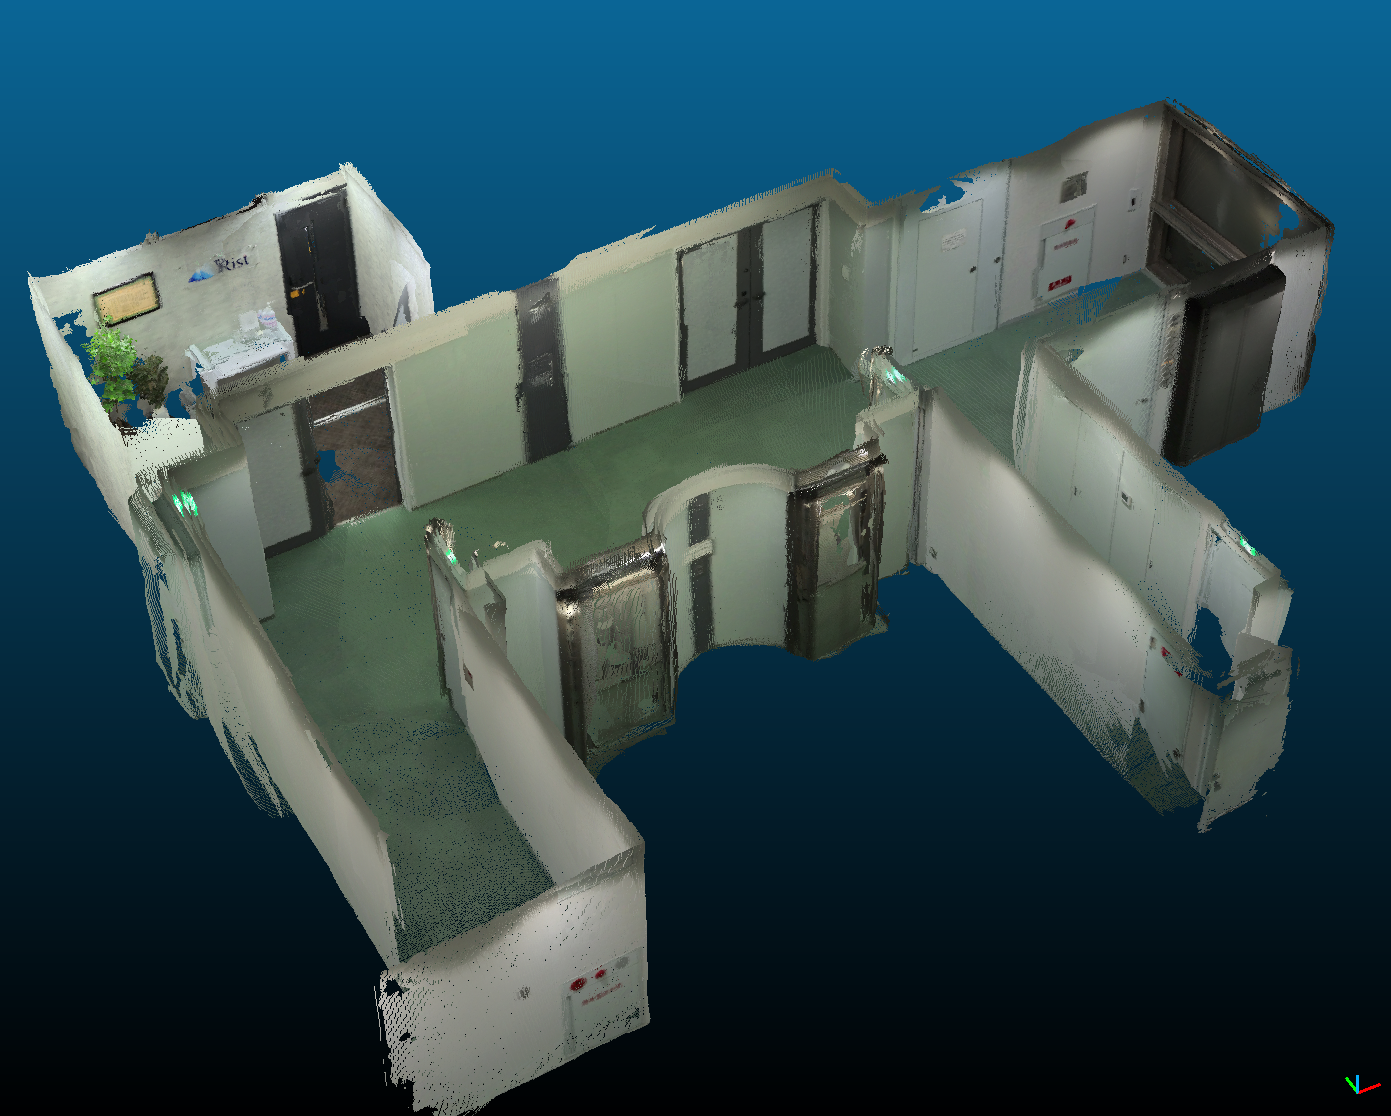
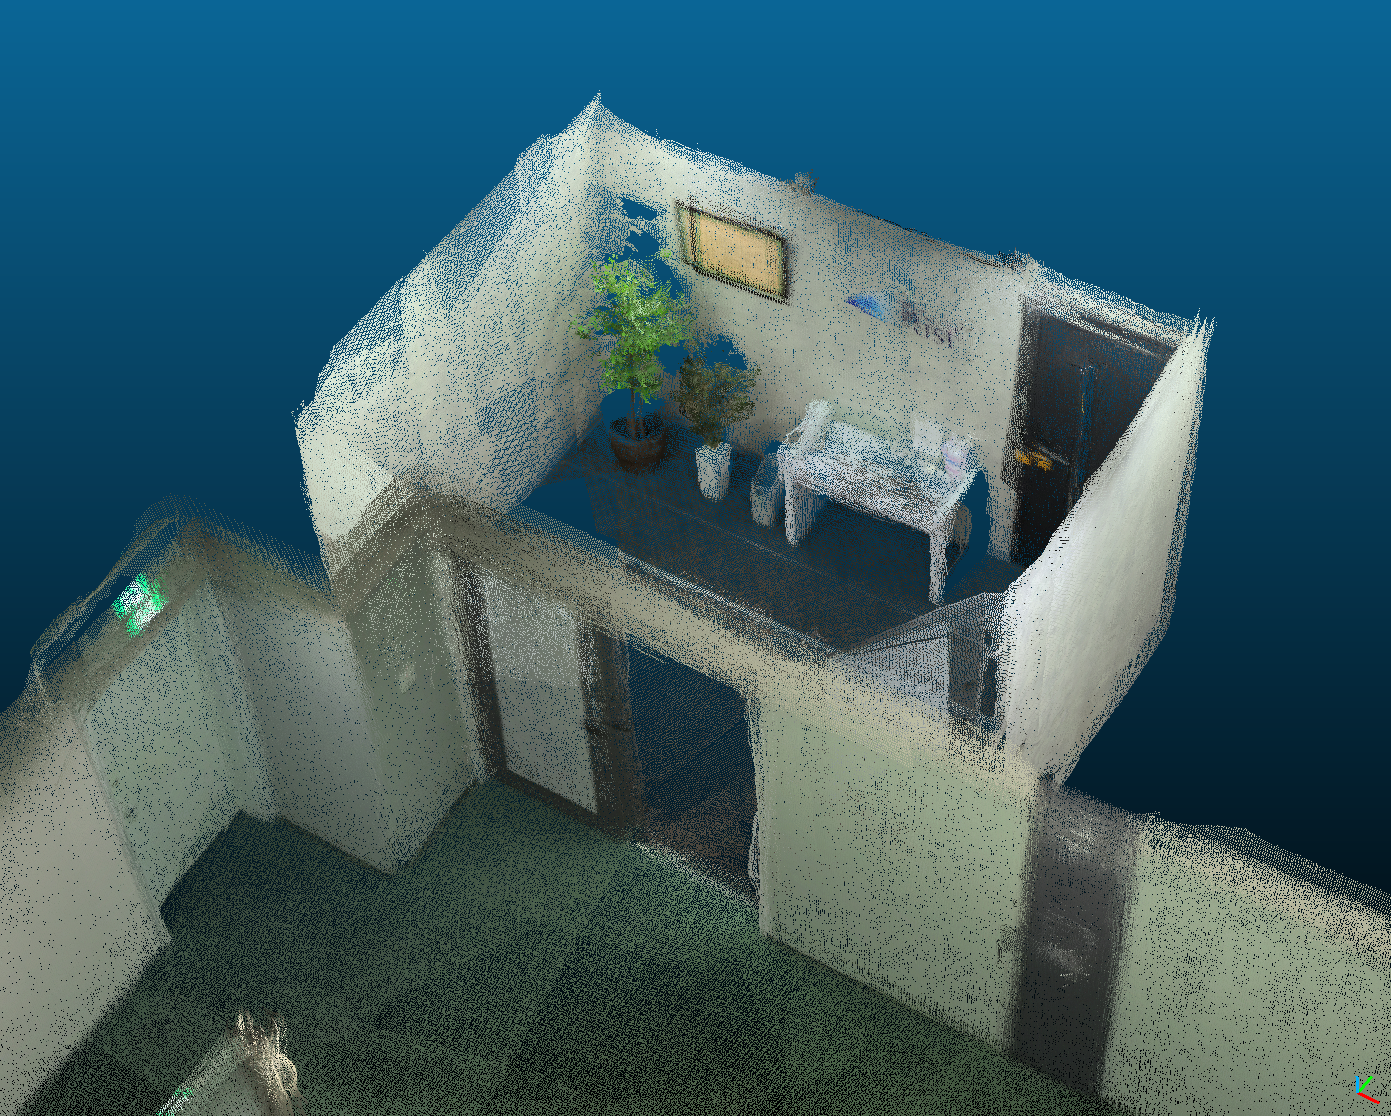
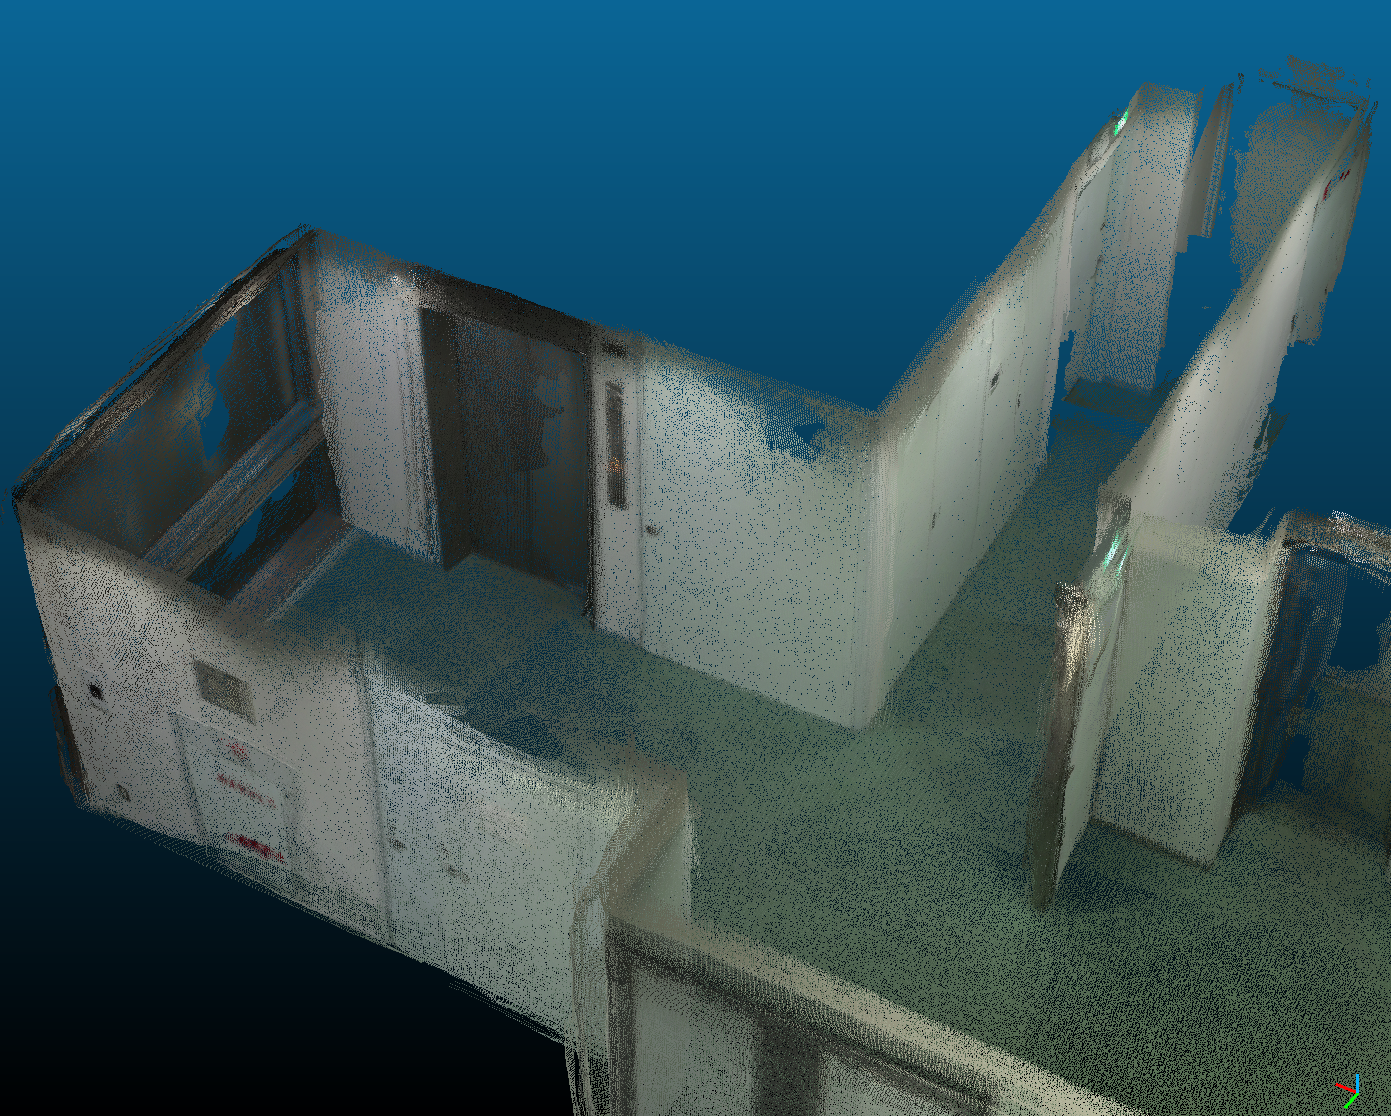
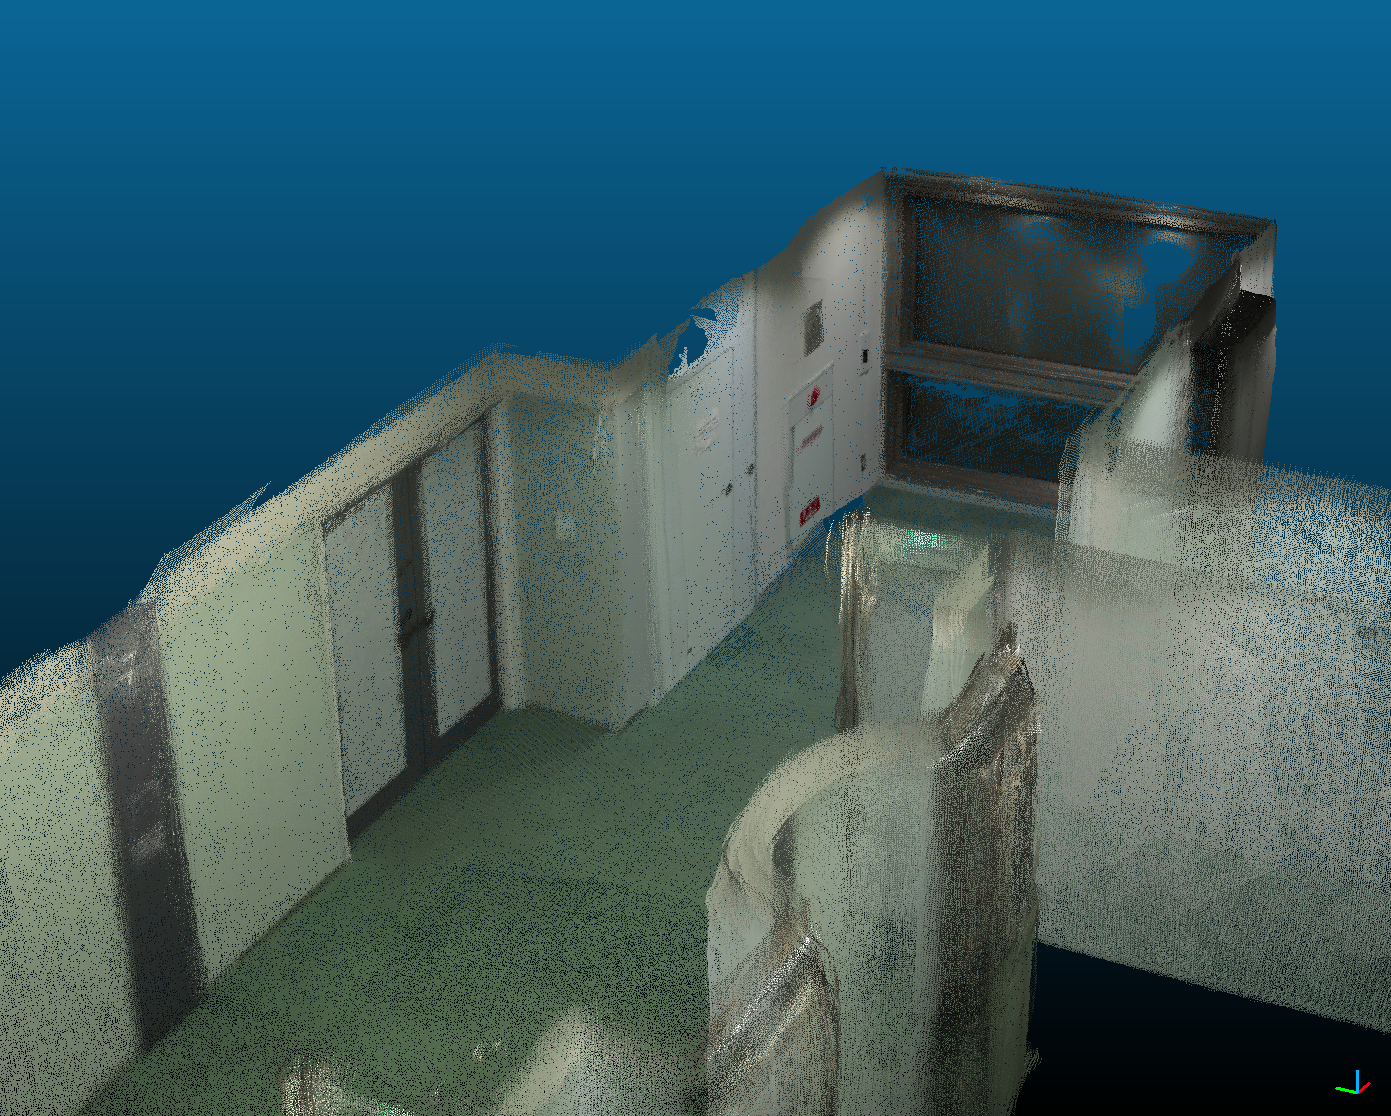
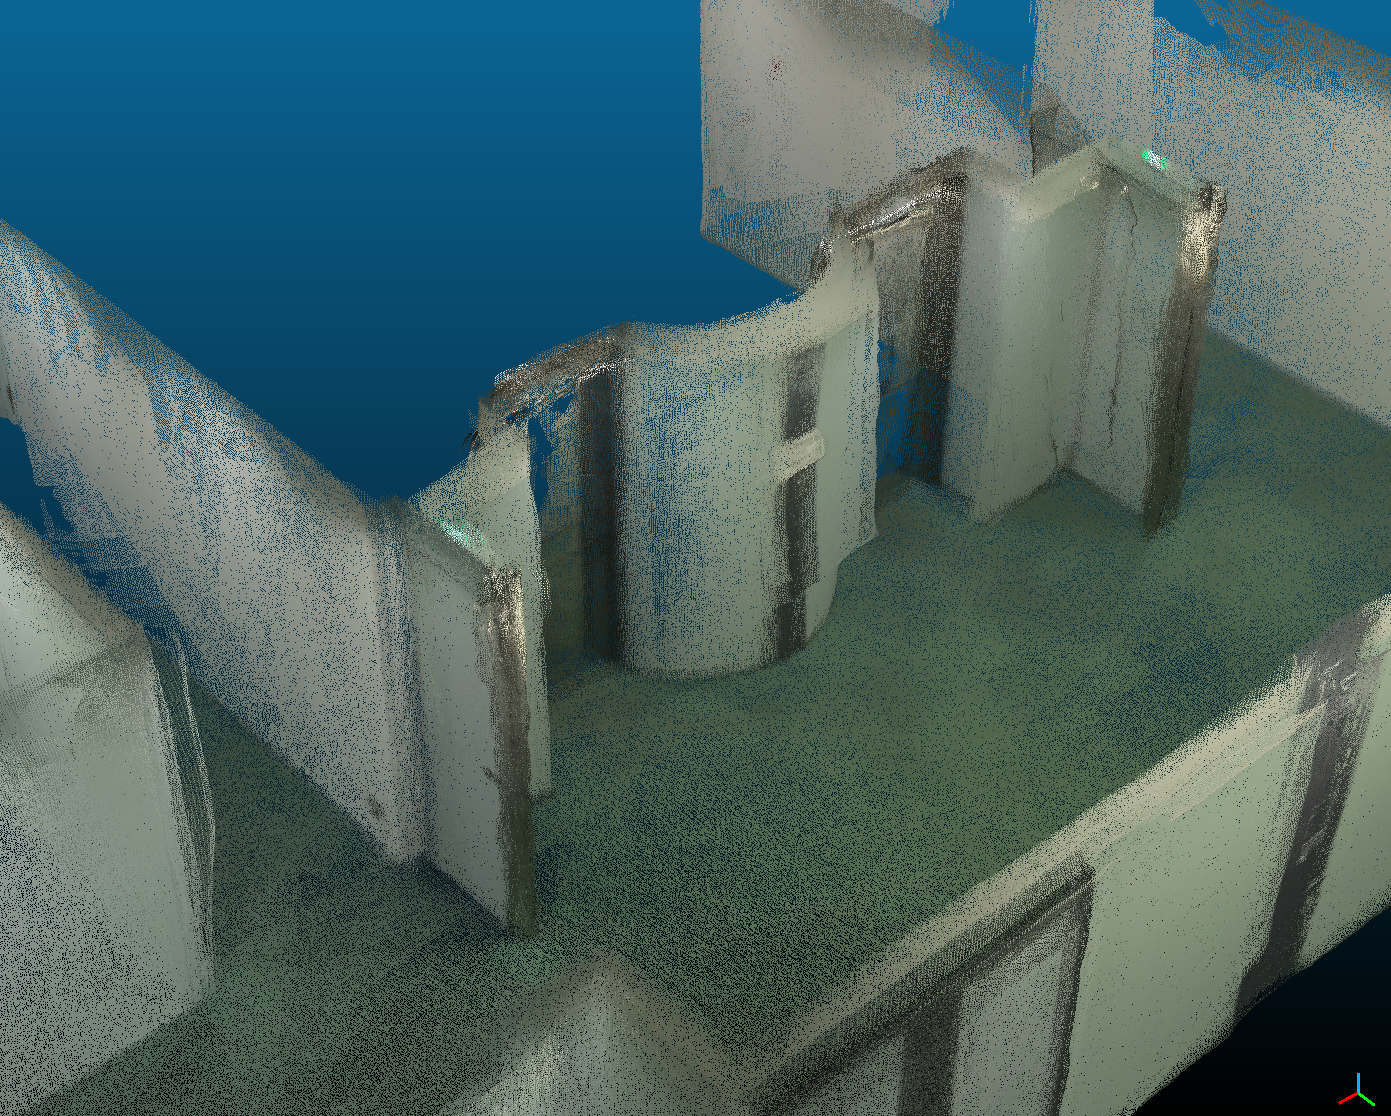
じっくり見ると壁が二重になってしまっているところがありますね。同じ場所を別のタイミングで撮影した分がぴったりとは重ならず、ズレが残ってしまったようです。この辺りは 3D LiDAR を使った 3D スキャナなどのほうが優れているでしょう。
とは言え、適当に歩きながら撮影した動画だけでこれほど密な点群が、この程度の誤差で作成できるのはすごいことです!
ポンと出す AI(feed-forward な手法)との比較
さて、今回は撮影後の動画を対象に実験を行いました。ここで最初の「画像だけ入れたら点群とカメラ姿勢がポンと出てくる AI」の話に戻ります。撮影済みデータなら SLAM じゃなくて、そのまま AI に入れたら良いんじゃないの? という疑問が湧いてきてしまいます。
はい。実はそれは一理あります。今回 ScaRF-SLAM で使った画像は適切に間引かれ、256 枚になっています。ScaRF-SLAM は「ポンと出す AI」と比較して、GPU メモリの使用量を削減できると書きましたが、48 GB くらいのメモリを持つ GPU であれば、問題なく今回の 256 枚の画像で「ポンと出す AI」が実行できてしまいます(もちろん手法や条件によってはもっと必要ですが…)。事前に VI-SLAM で姿勢を推定しておけば、それも入力できます。
ということで、せっかくなのでこちらも実行して結果を見てみましょう。早速結果をドン!
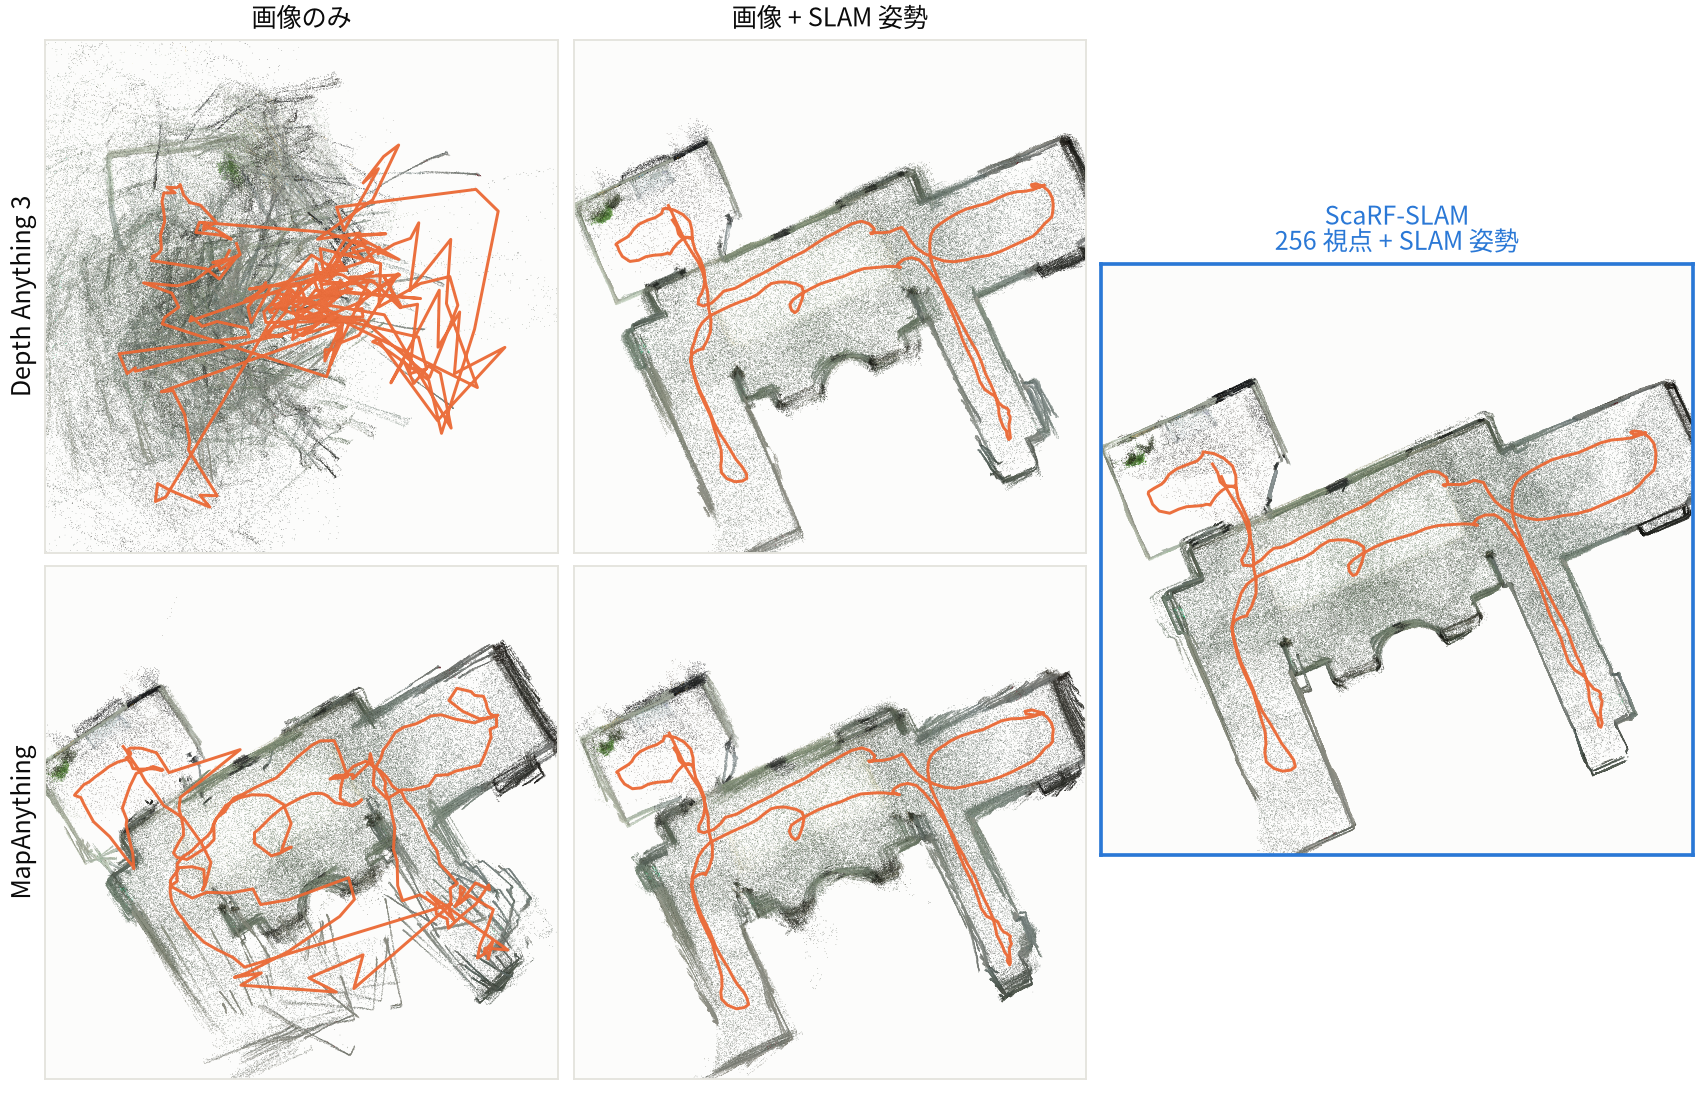
VI-SLAM の結果は ScaRF-SLAM 実行時のものを使い、画像は等間隔で、10 枚につき 1 枚になるようにしています。ScaRF-SLAM は使用するフレームも適切に選択しますが、こちらは単純に等間隔でピックアップした形です。なので ScaRF-SLAM とは画像枚数が若干異なっています。
試した手法はカメラ姿勢を入力可能な Depth Anything 3 (DA3-BASE) と MapAnything です。図の左側にある 4 枚のうち、上段が DA3、下段が MapAnything で、左列が画像のみ、右列が SLAM 姿勢も入力したものです。青枠で囲ったのが ScaRF-SLAM の結果ですね。
まず画像のみを与えた場合は全然ダメでした。DA3 では軌跡と点群の形状が大きく崩れ、MapAnything でも廊下部分が実際の形状から大きく外れています。やはり特徴の少ない廊下では、姿勢推定が難しかったのでしょうか。VI-SLAM は IMU の他、画像がシーケンシャルという情報もありますので、その辺りで姿勢推定に差がついた可能性もあります。
ところが SLAM 姿勢を与えると DA3 も MapAnything もきれいな点群と軌跡が得られています。DA3 の方が、壁が若干きれいに見えるでしょうか? 姿勢を与えれば一発でこれだけきれいな点群が得られてしまいました。
若干 ScaRF-SLAM の方がきれいに見えますが、DA3 と MapAnything は各フレームのデプスを単純に逆投影して点群化しただけです。一方、ScaRF-SLAM は複数視点を融合する際に様々な処理をしておりますので、この辺りで差がついたのかもしれません。
ちなみに実行時の GPU メモリの使用量を確認するとこんな感じでした。
| 手法 | 使い方 | GPU メモリ使用量 |
|---|---|---|
| DA3-BASE | 268 枚を一括 | 18.2 GiB |
| MapAnything | 268 枚を一括 | 30.3 GiB |
| ScaRF-SLAM (DA3-BASE) | 6枚ずつ 51回 | 2.2 GiB |
今回は社内の GPU サーバで問題なく実行できましたが、画像枚数が増えたり、もっとメモリ容量の少ない GPU で実行したいとなったり、はたまた最新のもっとメモリを多く要求するような手法を使いたい、となったら厳しそうです。そういうときに ScaRF-SLAM の考え方は役に立つでしょう。
おわりに
はい、ということで ScaRF-SLAM で密な点群を生成し、更に DA3 と MapAnything も試して比較してみました。
前回 AIMERA にハンドルをつけて撮影したときは腕がとてもしんどかったのですが、今回は 360 度カメラに自撮り棒をつけただけだったので非常に腕が楽でした。もしリアルタイムに処理したいという話になると、ここに PC を接続することなどを考える必要が出てくるのですが、後処理なら手軽に撮影できて良いですね。
最近は 3DGS などのリアルな描画が可能な手法も流行っておりますが、計測など、実際に点群がほしいというケースも多くあると思います。そういうときに手軽に密な点群が得られる ScaRF-SLAM は選択肢になるかもしれません。
ただ壁が二重になったりと、点群の位置精度では、やはり LiDAR を搭載した高価な 3D スキャナには敵いません。ScaRF-SLAM の利点は、比較的安価なカメラを持って適当に歩けば密な点群をすぐ出せる、という点でしょうか。また画像ベースだと以前からある SfM+MVS でも密な点群が生成可能ですが、SfM や MVS が苦手としがちな白い壁のような場所でも点群が取得できていたのは良いところかなと思います。
feed-forward な手法もまだまだ発展途上で、最初に書いたように数ヶ月おきに新しい手法が出てきている状況です。そちらの発展も含めて、今後どうなっていくか楽しみですね。
それでは!